AMD MI355X для ИИ: характеристики, ROCm и задачи, для которых он подходит
У MI355X на каждом GPU 288 ГБ HBM3e и пропускная способность 8 ТБ/с. Разбираем, что это вам даёт, в каком состоянии программный стек ROCm на практике и как понять, подходит ли MI355X для вашей задачи.
 Инженерная команда FullGPU
Обновлено 8 мин чтения
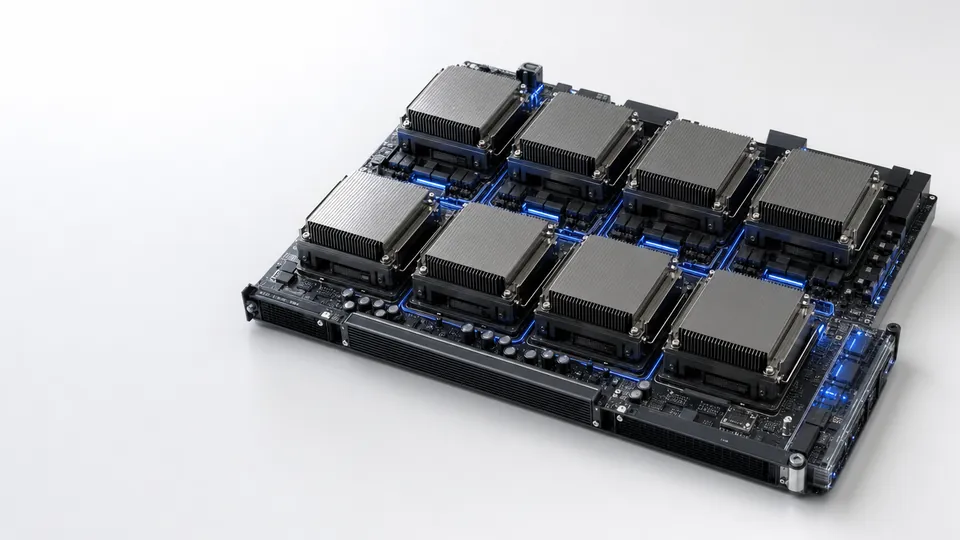
Аргументы в пользу AMD MI355X для задач ИИ умещаются в одну строку: 288 ГБ HBM3e на каждый GPU при пропускной способности 8 ТБ/с — столько же памяти, сколько у NVIDIA B300. В нашем каталоге сервер 8× MI355X стоит в месяц примерно вдвое дешевле сервера 8× B300 с тем же объёмом видеопамяти (VRAM) — 2 304 ГБ. Настоящие вопросы касаются программного обеспечения и того, подходит ли он вашей задаче: что уже сегодня работает на ROCm, что придётся портировать и относится ли ваша задача к тем, где объём памяти и пропускная способность превращаются в результат. В этом руководстве мы отвечаем на оба вопроса — с цифрами.
AMD MI355X для ИИ: ключевые характеристики
- Архитектура AMD CDNA 4
- Память
288 ГБ HBM3e на GPU, 2 304 ГБ в 8-GPU-сервере - Пропускная способность памяти 8 ТБ/с на GPU
- FP8 5,0 PFLOPS без разреженности, 10,1 PFLOPS с разреженностью
- BF16 2,5 PFLOPS без разреженности, 5,0 PFLOPS с разреженностью
- MXFP4 10,1 PFLOPS
- Форматы пониженной точности FP8, MXFP6 и MXFP4
- Связь между GPU Infinity Fabric, 7 каналов по 153,6 ГБ/с
- Модуль и энергопотребление
Форм-фактор OAM, 1 400 Вт, жидкостное охлаждение
Сравнение MI355X с B200, B300 и H200
| Критерий | MI355X | B300 | B200 | H200 |
|---|---|---|---|---|
| Память | 288 ГБ HBM3e | 288 ГБ HBM3e | 180 ГБ HBM3e | 141 ГБ HBM3e |
| Пропускная способность | 8 ТБ/с | ~8 ТБ/с | 8 ТБ/с | 4,8 ТБ/с |
| FP8, без разреженности | 5,0 PFLOPS | 4,5 PFLOPS | 4,5 PFLOPS | 1 979 TFLOPS |
| 4 бита, без разреженности | 10,1 PFLOPS (MXFP4) | 13,5 PFLOPS (FP4) | 9 PFLOPS (FP4) | Не поддерживается |
| Связь между GPU | Infinity Fabric, 7 × 153,6 ГБ/с | NVLink 5, 1,8 ТБ/с | NVLink 5, 1,8 ТБ/с | NVLink 4, 900 ГБ/с |
| Энергопотребление | 1 400 Вт, жидкостное охлаждение | ~1 100 Вт (по отраслевым данным) | ~1 000 Вт | 700 Вт |
| Программный стек | ROCm | CUDA | CUDA | CUDA |
| 19 900 $ | 39 900 $ | 34 900 $ | 23 900 $ | |
| 3,41 $ | 6,83 $ | 5,98 $ | 4,09 $ |
FP8, MXFP6 и MXFP4 на CDNA 4
Помимо FP8, CDNA 4 поддерживает два формата с поблочным масштабированием из спецификации Microscaling (MX) от Open Compute Project:
- FP8 хранит один байт на значение. Для инференса это обычный следующий шаг вниз после BF16: он вдвое сокращает память под веса.
- MXFP6
хранит 6-битные значения блоками по 32 значения с одним общим масштабом, равным степени двойки: около 6,25 бита на значение с учётом масштаба. - MXFP4
делает то же самое с 4-битными значениями: около 4,25 бита на значение.
Программный стек ROCm на практике
ROCm — открытый программный стек AMD: драйвер уровня ядра ОС, модель программирования HIP и компиляторы, математические библиотеки и RCCL для коллективного обмена данными между GPU. Для большинства команд полезен не вопрос «зрелый ли ROCm?», а вопрос «работают ли на нём мой фреймворк и движок инференса и работают ли функции, которыми я пользуюсь?». Основные компоненты действительно работают.
| Уровень | Состояние в ROCm | Что проверить |
|---|---|---|
| PyTorch | Официальные сборки для ROCm; код, написанный под API torch.cuda, работает через HIP | |
| vLLM и SGLang | Оба поддерживают ROCm | Форматы квантования, бэкенды механизма внимания и функции, на которые вы полагаетесь, поддерживаются в ROCm в вашей версии |
| Коллективные операции | RCCL — аналог NCCL от AMD; на ROCm его использует бэкенд «nccl» в PyTorch | |
| Ядра Triton | Компилятор Triton умеет генерировать код для GPU AMD | Размеры блоков и параметры запуска заново подобраны под это оборудование |
| Собственные ядра CUDA | Их нужно портировать на HIP; инструменты AMD HIPIFY переводят значительную часть исходного кода | Допущения о размере warp (CDNA выполняет wavefront по 64 потока, NVIDIA — warp по 32), встроенный PTX, библиотеки только для CUDA |
| ПО только для NVIDIA | Замена с поддержкой ROCm для каждого из них |
На практике объём работы по переносу зависит от того, насколько вы держитесь распространённых решений. Стек на PyTorch с vLLM или SGLang, который обслуживает модель стандартной архитектуры, в основном переносится сменой контейнеров и фиксацией версий. Стеку с написанными вручную ядрами CUDA понадобится время инженеров: HIP намеренно сделан близким к CUDA, и HIPIFY механически выполняет большую часть перевода, но критичные для производительности ядра обычно приходится настраивать под новое оборудование. О первых шагах на наших серверах AMD — в нашем руководстве по настройке ROCm.
Задачи, в которых MI355X себя оправдывает
Инференс очень больших моделей, упирающийся в память
Длинные контексты
Большие MoE-модели (mixture of experts)
Когда лучше выбрать сервер NVIDIA
MI355X подходит не всем. Выбирайте сервер NVIDIA в следующих случаях:
Ваш пайплайн зависит от компонентов, работающих только с CUDA, — например, TensorRT-LLM , собственных ядер CUDA или библиотек CUDA с закрытым исходным кодом, — а выделить время на их перенос вы не можете.- Ваша задача сильно зависит от пропускной способности связи между GPU — например, при интенсивном тензорном параллелизме в обучении. Серверы HGX B200 и B300 дают каждому GPU 1,8 ТБ/с по NVLink 5.
Вам нужен домен NVLink больше одного сервера — такой дают стоечные системы ( rack-scale ), например GB300 NVL72.- Ваши модели небольшие. Модель размером от 7B до 14B не требует 288 ГБ на GPU: её обслужит один RTX PRO 6000 за 1 390 $ в месяц или L40S за 890 $.
- Вы используете чекпоинты NVFP4 или другие квантованные форматы, специфичные для NVIDIA.
Как оценить MI355X: запустите свою задачу на месяц
Опубликованные сравнения редко совпадают с вашей моделью, составом промптов и целевой задержкой. Надёжная проверка — ваша собственная задача на этом оборудовании, причём достаточно долго, чтобы успеть её настроить: месяца хватает, чтобы всё развернуть, настроить и провести замеры под реальной нагрузкой. Практический план:
- Сначала — базовый уровень. Зафиксируйте качество на своём наборе данных для оценки и производительность при целевой задержке на оборудовании, которым пользуетесь сейчас, — с той же моделью, точностью и настройками движка.
- Разверните стек. Начните с образа ROCm, соответствующей сборки PyTorch и контейнера vLLM или SGLang для ROCm. Зафиксируйте все версии.
- Проверьте корректность. Сравните ответы модели на своём наборе данных для оценки, прежде чем измерять скорость.
- Измеряйте то, что продаёте. Время до первого токена, задержку между токенами и производительность при вашем реальном числе одновременных запросов и реальных длинах контекста. Сравните тензорный параллелизм на всех восьми GPU с несколькими репликами поменьше.
- Проверьте коллективные операции
, если вы обучаете или шардируете модели: запустите бенчмарк all-reduce изrccl-tests на всех восьми GPU. - Посчитайте стоимость единицы работы. Разделите 19 900 $ на число токенов или задач в месяц, которое вы можете обслужить при своих целевых показателях, и сравните с базовым уровнем.
# Check the GPUs, and that PyTorch is a ROCm build (torch.version.hip is set)
rocm-smi
python3 -c "import torch; print(torch.version.hip, torch.cuda.device_count())"

# Serve a model across all eight GPUs with the ROCm build of vLLM
vllm serve <model> --tensor-parallel-size 8
Наш сервер 8× MI355X
Часто задаваемые вопросы
Подходит ли AMD MI355X для ИИ?
Работает ли PyTorch на MI355X?
Да. PyTorch выпускает сборки для ROCm, и код, написанный под API torch.cuda, как правило, работает через HIP без изменений. vLLM и SGLang тоже поддерживают ROCm.
Можно ли запускать код CUDA на GPU AMD?
Сколько памяти у сервера 8× MI355X?
Сколько стоит аренда сервера MI355X?
Выделенные GPU с помесячной оплатой